



Pemanfaatan Algoritma Decision Tree untuk Klasifikasi Pelanggan Gagal Bayar
Decision Tree merupakan salah satu algoritma supervised learning yang cukup populer dan memiliki intepretasi yang mudah. Cara kerja model ini adalah dengan membangun struktur decision menyerupai pohon, di mana setiap node internal berisi aturan, dan setiap daun berisi prediksi akhir. Berkat interpretabilitasnya yang tinggi, Decision Tree banyak digunakan pada aplikasi bisnis, keuangan, pemasaran, kesehatan, dan sistem pendukung keputusan.
Konsep Dasar Decision Tree
Decision Tree bekerja dengan memecah dataset menjadi kelompok-kelompok yang lebih homogen. Untuk memilih fitur terbaik pada tiap langkah pemecahan, algoritma menggunakan ukuran ketidakmurnian (impurity) seperti Gini Index atau Entropy. Dalam implementasi yang digunakan, model mengadopsi criterion = “entropy”, yang berarti pemilihan fitur didasarkan pada Information Gain. Information Gain mengukur seberapa besar peningkatan “kemurnian” kelas setelah data dibagi menggunakan suatu fitur. Fitur yang memberikan Information Gain tertinggi dianggap paling efektif dan dipilih sebagai dasar pemisahan node.
Pohon dibangun secara rekursif hingga mencapai stopping criteria, seperti:
-
- Maksimal kedalaman pohon (max_depth)
- Minimal sampel dalam satu daun (min_samples_leaf)
- Tidak ada Information Gain lebih lanjut
- Impurity mencapai nol
Proses Pembentukan Pohon Keputusan
Pembentukan Decision Tree terdiri dari beberapa tahap penting:
- Pemilihan Fitur Terbaik
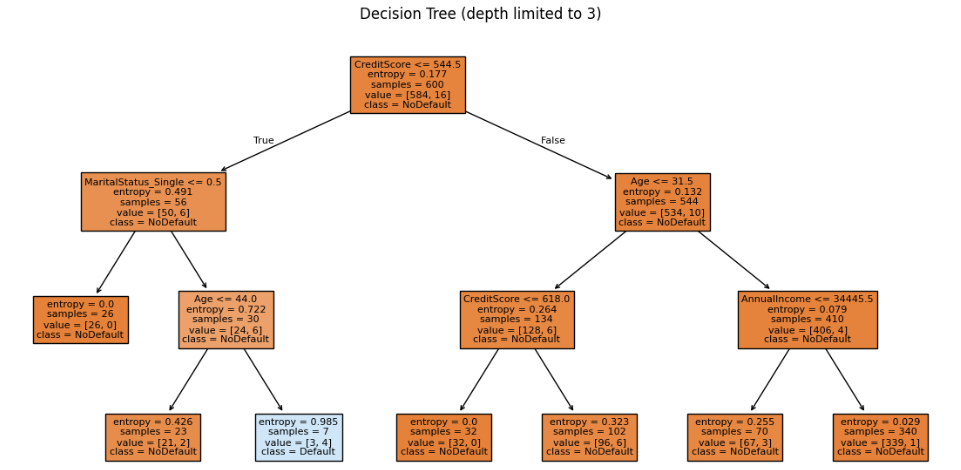
Setiap fitur dievaluasi menggunakan entropy untuk menghitung seberapa bersih pembagian data yang dihasilkan. Fitur dengan Information Gain tertinggi dipilih.
- Pembagian Dataset Secara Rekursif
Setelah fitur dipilih, dataset dibagi menjadi subset berdasarkan nilai fitur tersebut. Proses ini terus berlangsung hingga memenuhi kondisi berhenti.
- Penerapan Kriteria Berhenti
Dalam implementasi, digunakan:
-
- max_depth = 6
- min_samples_leaf = 3
Parameter ini mencegah overfitting dengan membatasi kompleksitas pohon.
- Pembentukan Node Daun
Node daun menunjukkan kelas akhir (Default atau NoDefault) berdasarkan mayoritas data pada cabang tersebut.
Implementasi Decision Tree
Pada artikel ini, digunakan data pelanggan, termasuk fitur kategorik seperti pekerjaan atau status pernikahan, serta fitur numerik seperti jumlah kredit atau pendapatan untuk menentukan apakah pelanggan tersebut akan gagal bayar atau tidak. Berikut merupakan tahap pemrosesan data yang dilakukan:
- Preprocessing Data
- Memisahkan fitur (X) dan target (y)
- Mengidentifikasi fitur kategorik dan numerik
- Menggunakan OneHotEncoder untuk fitur kategorik
- Menggunakan ColumnTransformer untuk memadukan semua preprocessing
- Membuat Pipeline Model
Pipeline terdiri dari preprocessing dan classifier:
|
model = Pipeline(steps=[ (“preprocess”, preprocess), (“clf”, DecisionTreeClassifier( criterion=”entropy”, max_depth=6, min_samples_leaf=3, random_state=0 )) ]) |
- Melatih Model dan Prediksi
Dataset dibagi menggunakan train_test_split (75% training, 25% testing). Model dilatih dengan model.fit(), dan prediksi dilakukan untuk menghitung akurasi, AUC, dan metrik lain.
- Evaluasi Model
Evaluasi dilakukan dengan:
-
- Accuracy: proporsi prediksi yang benar
- ROC-AUC: kemampuan membedakan Default dan NoDefault
- Confusion Matrix
- Classification Report (precision, recall, F1-score)
- Visualisasi Tree dan Feature Importance
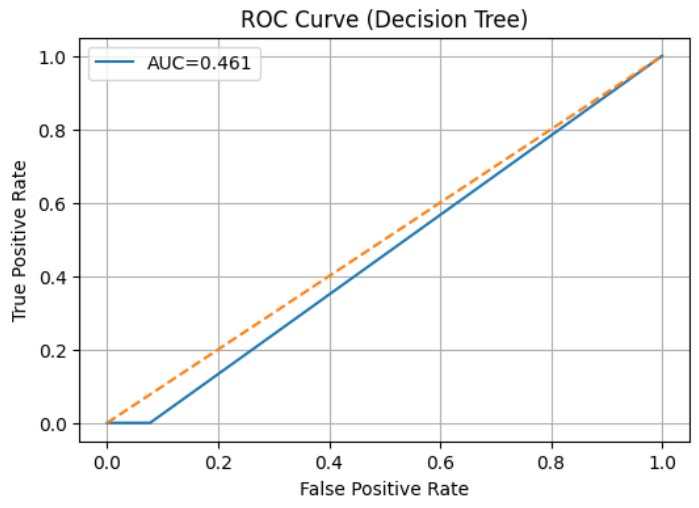
Pada percobaan ini menunjukkan Decision Tree mampu memberikan prediksi yang cukup baik. ROC Curve menggambarkan trade-off antara True Positive Rate dan False Positive Rate.
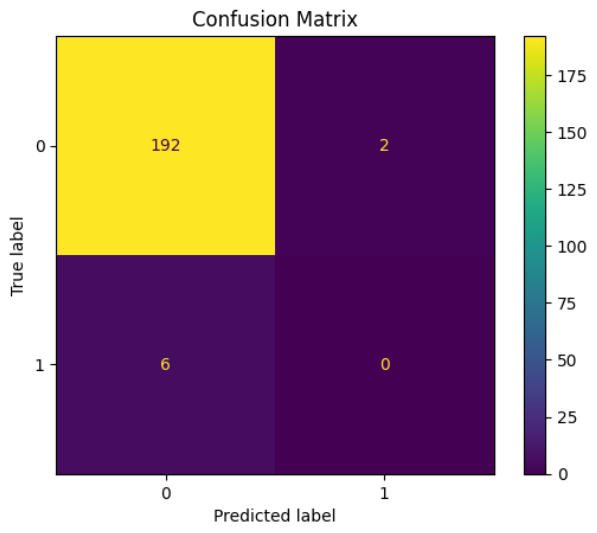
Confusion matrix memberikan detail jumlah prediksi benar dan salah. Feature importance menjadi alat sangat berguna bagi stakeholder untuk memahami faktor dominan yang menyebabkan seorang pelanggan berpotensi mengalami default.
Referensi:
Comments :